Orquestacion de Agentes Autonomos (Nova)
Agencia de agentes CrewAI con CEO, 5 divisiones y 29 especialistas que ejecutan trabajo real 24/7 — API FastAPI, grafo 3D, trazas SSE e inferencia local. No es un chatbot: es un negocio operado por IA.
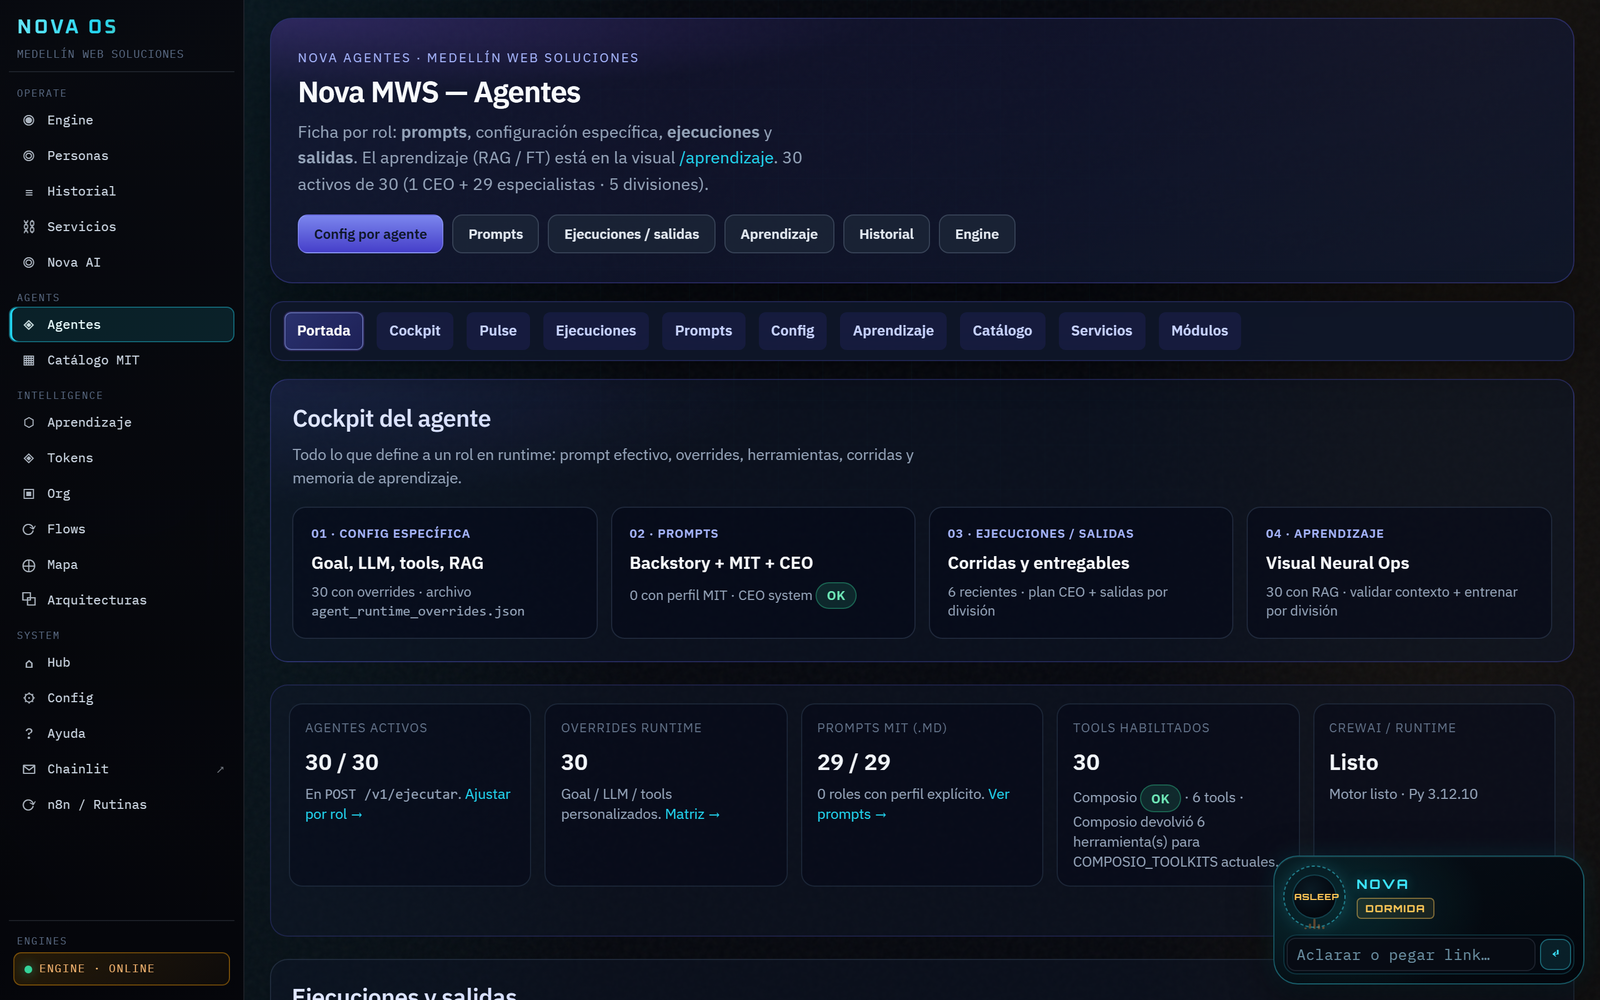
Nova MWS es un producto de orquestacion real, no un chatbot con nombre bonito. Coordina una red de 29 agentes especializados (research, contenido, ops) con configuracion por agente, trazabilidad en vivo y puente directo a los datos de negocio de MWS.
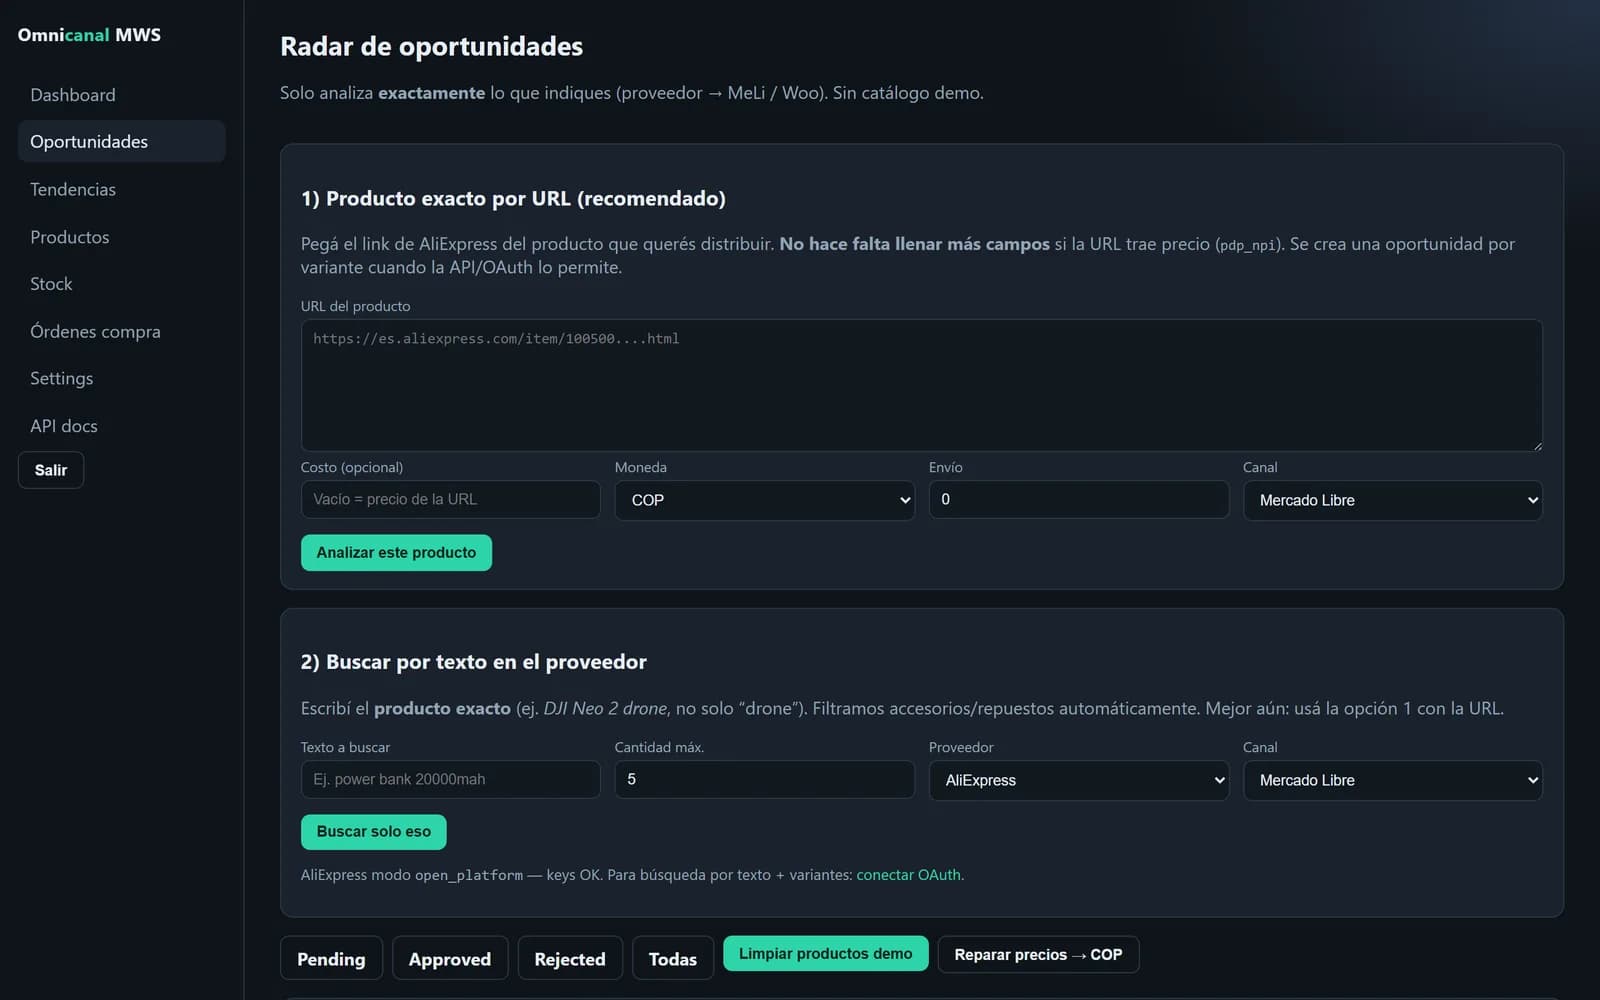
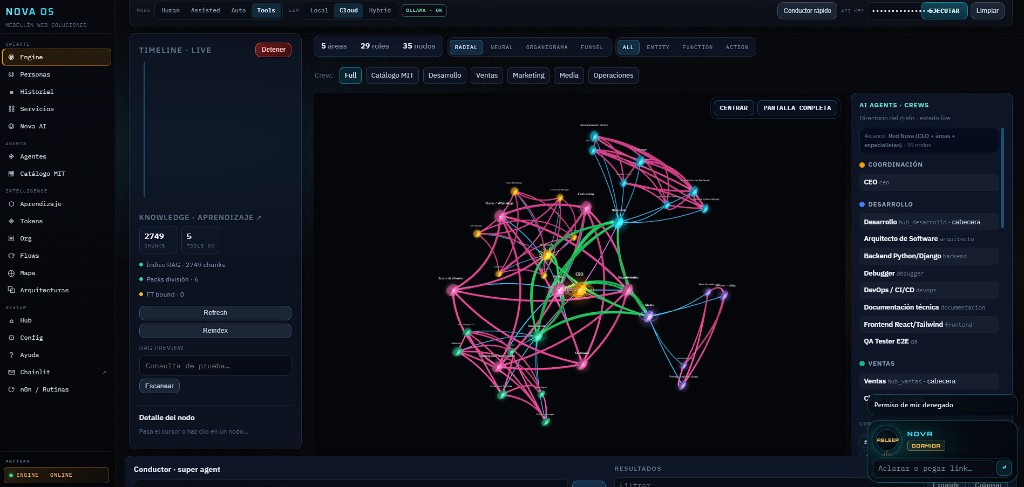
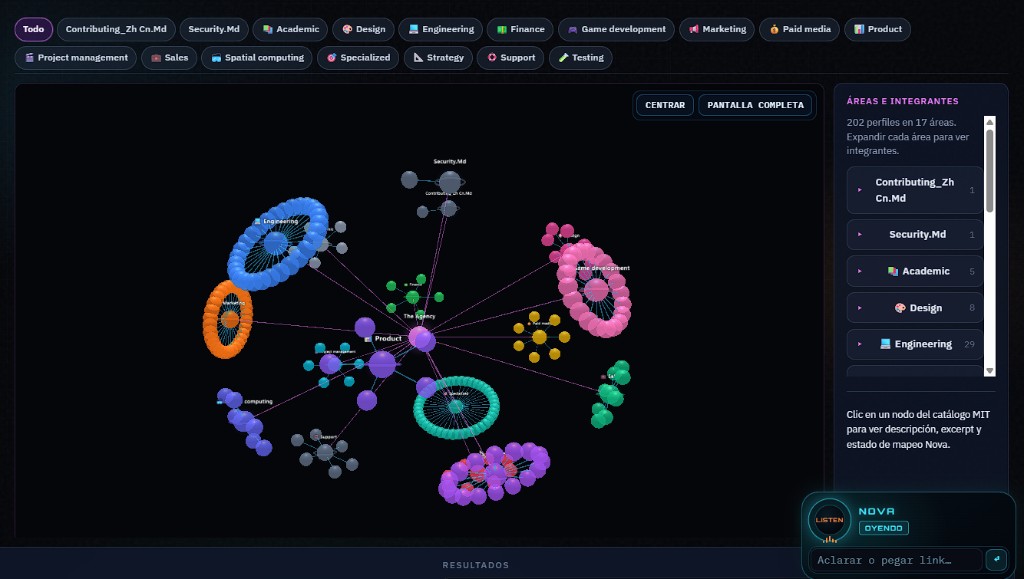
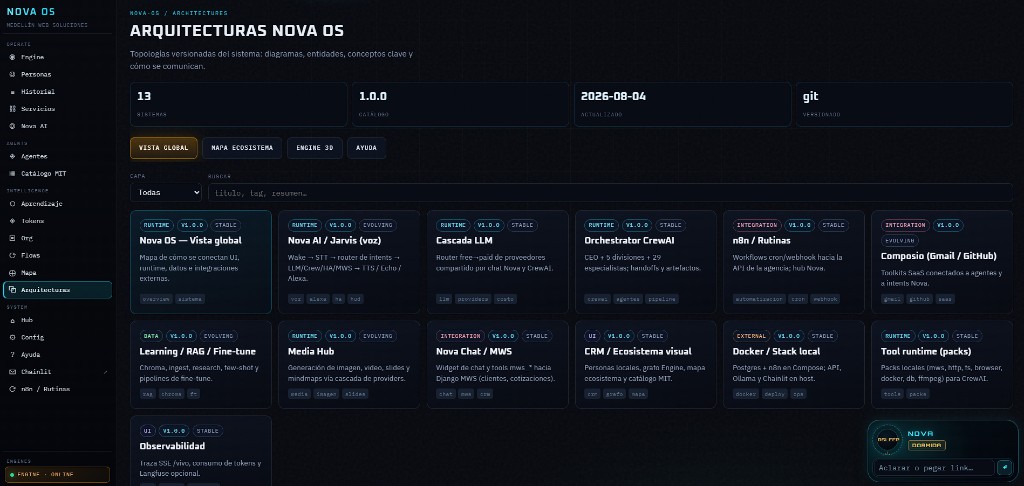
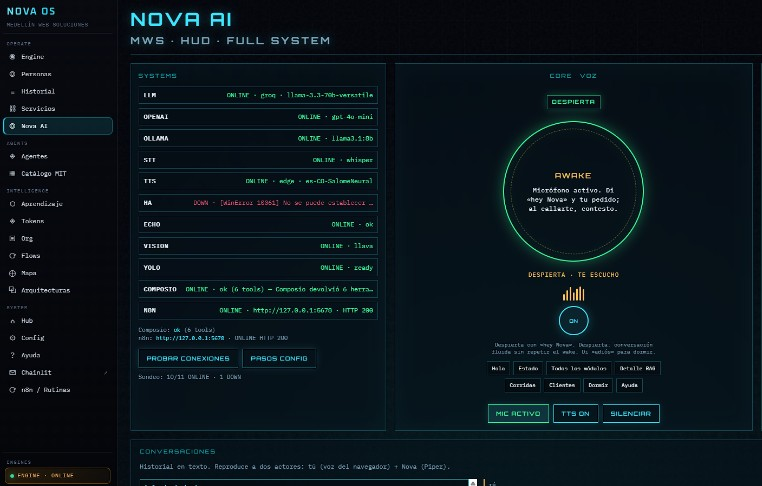
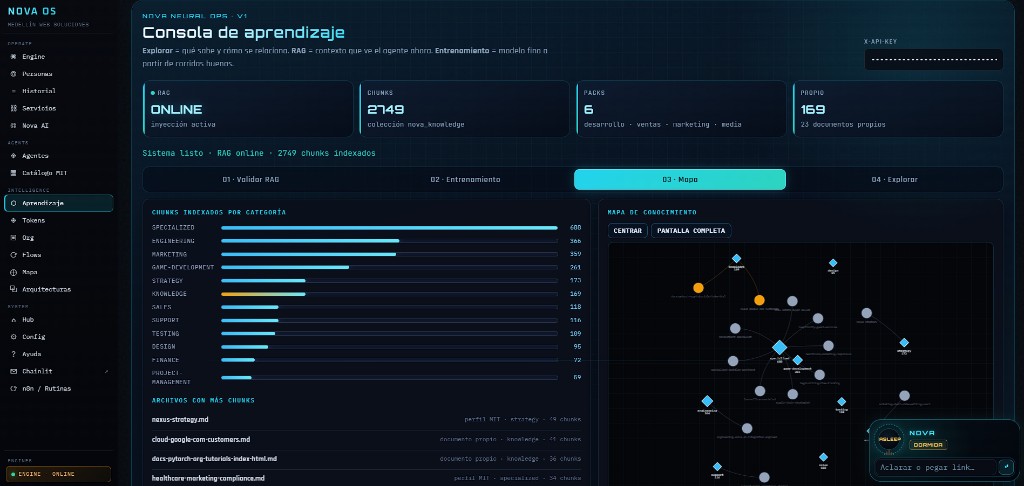
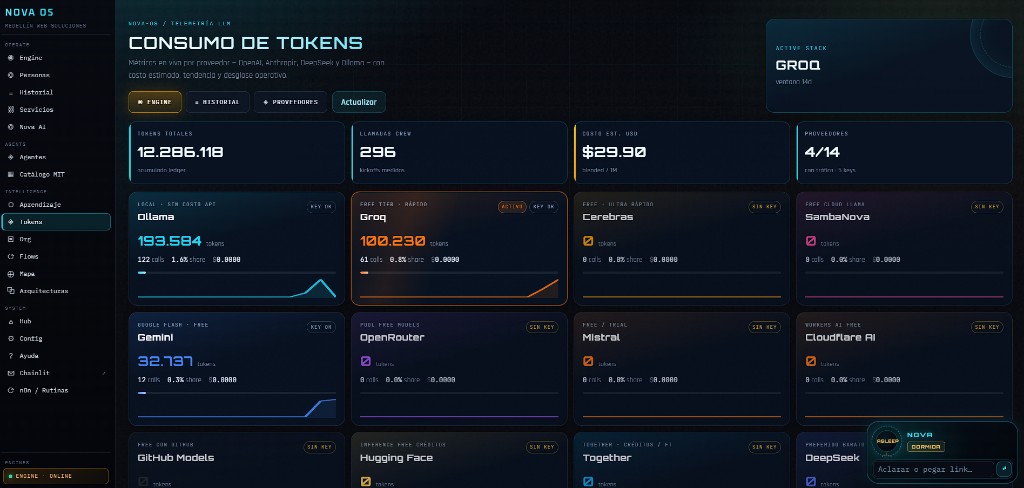
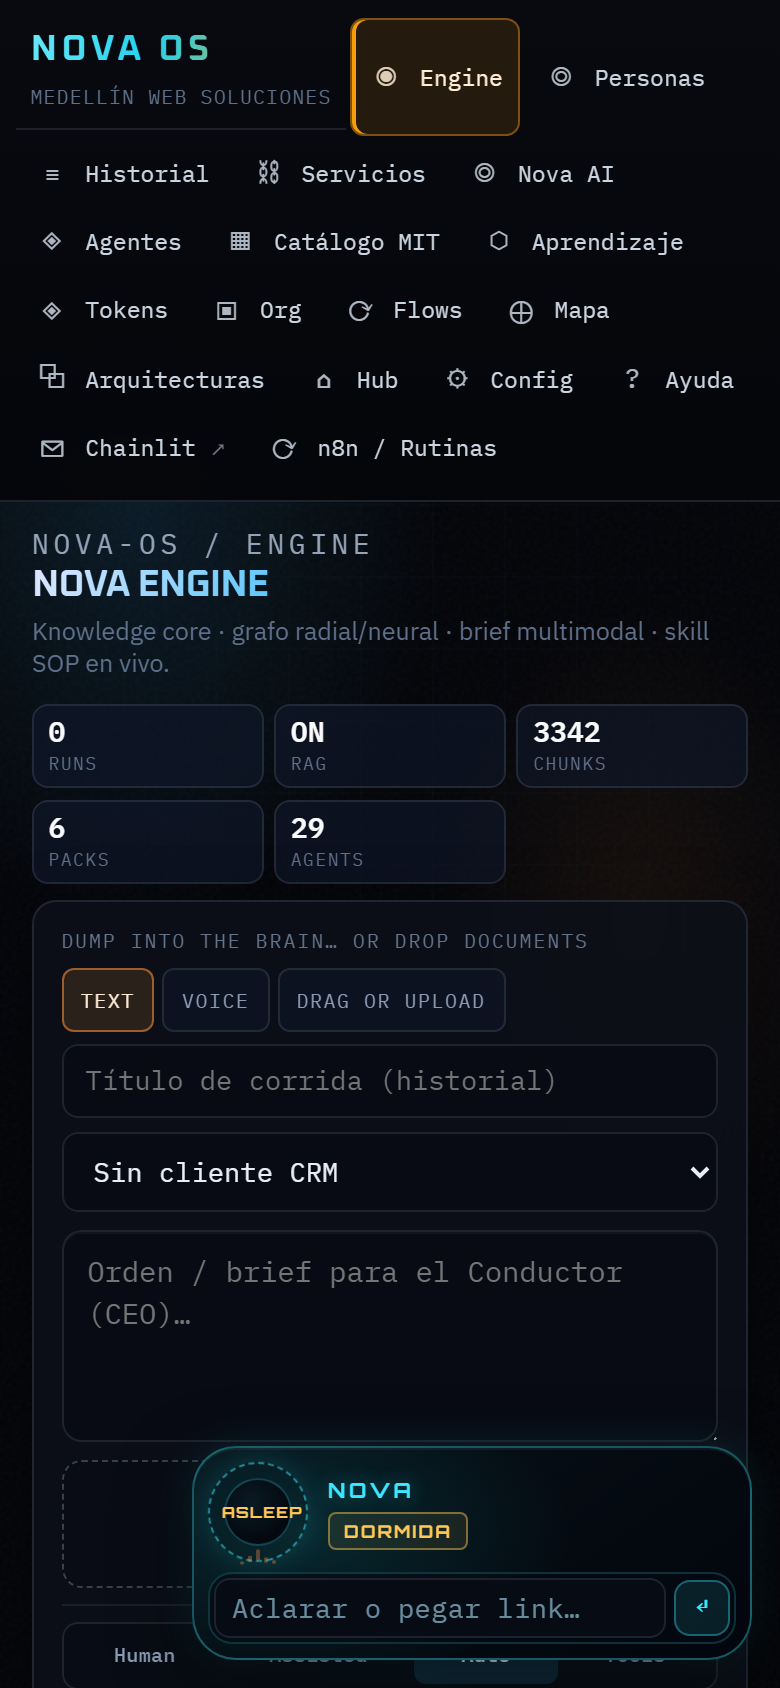
Capturas reales del sistema en operacion.
Problema
- 1Reducir carga operativa manual sin perder control.
- 2Mantener privacidad con inferencia local cuando aplica.
- 3Hacer observable una red de 30 roles.
- 4Desplegar de forma reproducible (Docker / VPS).
El enfoque
Diseno multi-agente
CEO + divisiones + 29 especialistas con routing explicito y overrides de runtime.
API + paneles operativos
FastAPI con /visual (grafo 3D), /vivo (SSE), /configuracion y health.
Inferencia local y tools
Ollama + herramientas MCP/Composio/MWS para ejecutar trabajo real, no solo texto.
Observabilidad
Trazas de corrida, Langfuse opcional y estado de modulos en configuracion.
Mapa parcial del plano de control: operador y panel vivo → API de orquestacion → hub director / divisiones / especialistas → inferencia local, tools acotadas y estado. No expone configs ni el inventario completo de agentes.
Capas del sistema
- 01UI operativa: /visual, /vivo, /configuracion
- 02API FastAPI: ejecutar, stream SSE, graph, health
- 03Orquestacion CrewAI: CEO → hubs → especialistas
- 04Inferencia: Ollama + overrides por agente
- 05Tools: MCP, Composio, pack MWS, n8n
- 06Datos: SQLite/PostgreSQL + runtime overrides
Stack aplicado
- Python
- CrewAI
- FastAPI
- Ollama
- RAG
- MCP
- Docker
- SSE
Decisiones de diseno
Local-first vs solo cloud LLM
Privacidad, costo predecible y operacion en perimetro del cliente.
Red especializada vs un solo asistente
Routing por dominio y ownership claro de cada capacidad.
Config por agente sin redeploy
Operar prompts/modelos/tools desde panel, no desde git cada vez.
Impacto
- 29+1
- Especialistas + CEO orquestados
- 12,2M
- Tokens y 296 llamadas de crew por ~USD 29,90 (cascada de 14 proveedores)
- 2.749
- Chunks RAG indexados sobre 159 documentos propios
- 11
- Subsistemas monitoreados en el HUD de salud
- 24/7
- Operacion continua con trazas
- Local
- Inferencia privada con Ollama
Puntos clave
- Producto con panel visual y ejecucion en vivo, no solo notebook.
- Arquitectura local-first con escapes a tools externas controladas.
- Ownership end-to-end: agentes, API, UI operativa y deploy.
Encaje / como contratar
Contrata esto si necesitas un Solutions Architect / AI automation lead que ya probo que un ecosistema de 29 agentes puede operar en produccion, no solo en un notebook. Empezamos con una llamada de 15 min; si el alcance lo pide, sigo como retainer de evolucion continua.
Agendar llamada tecnica